


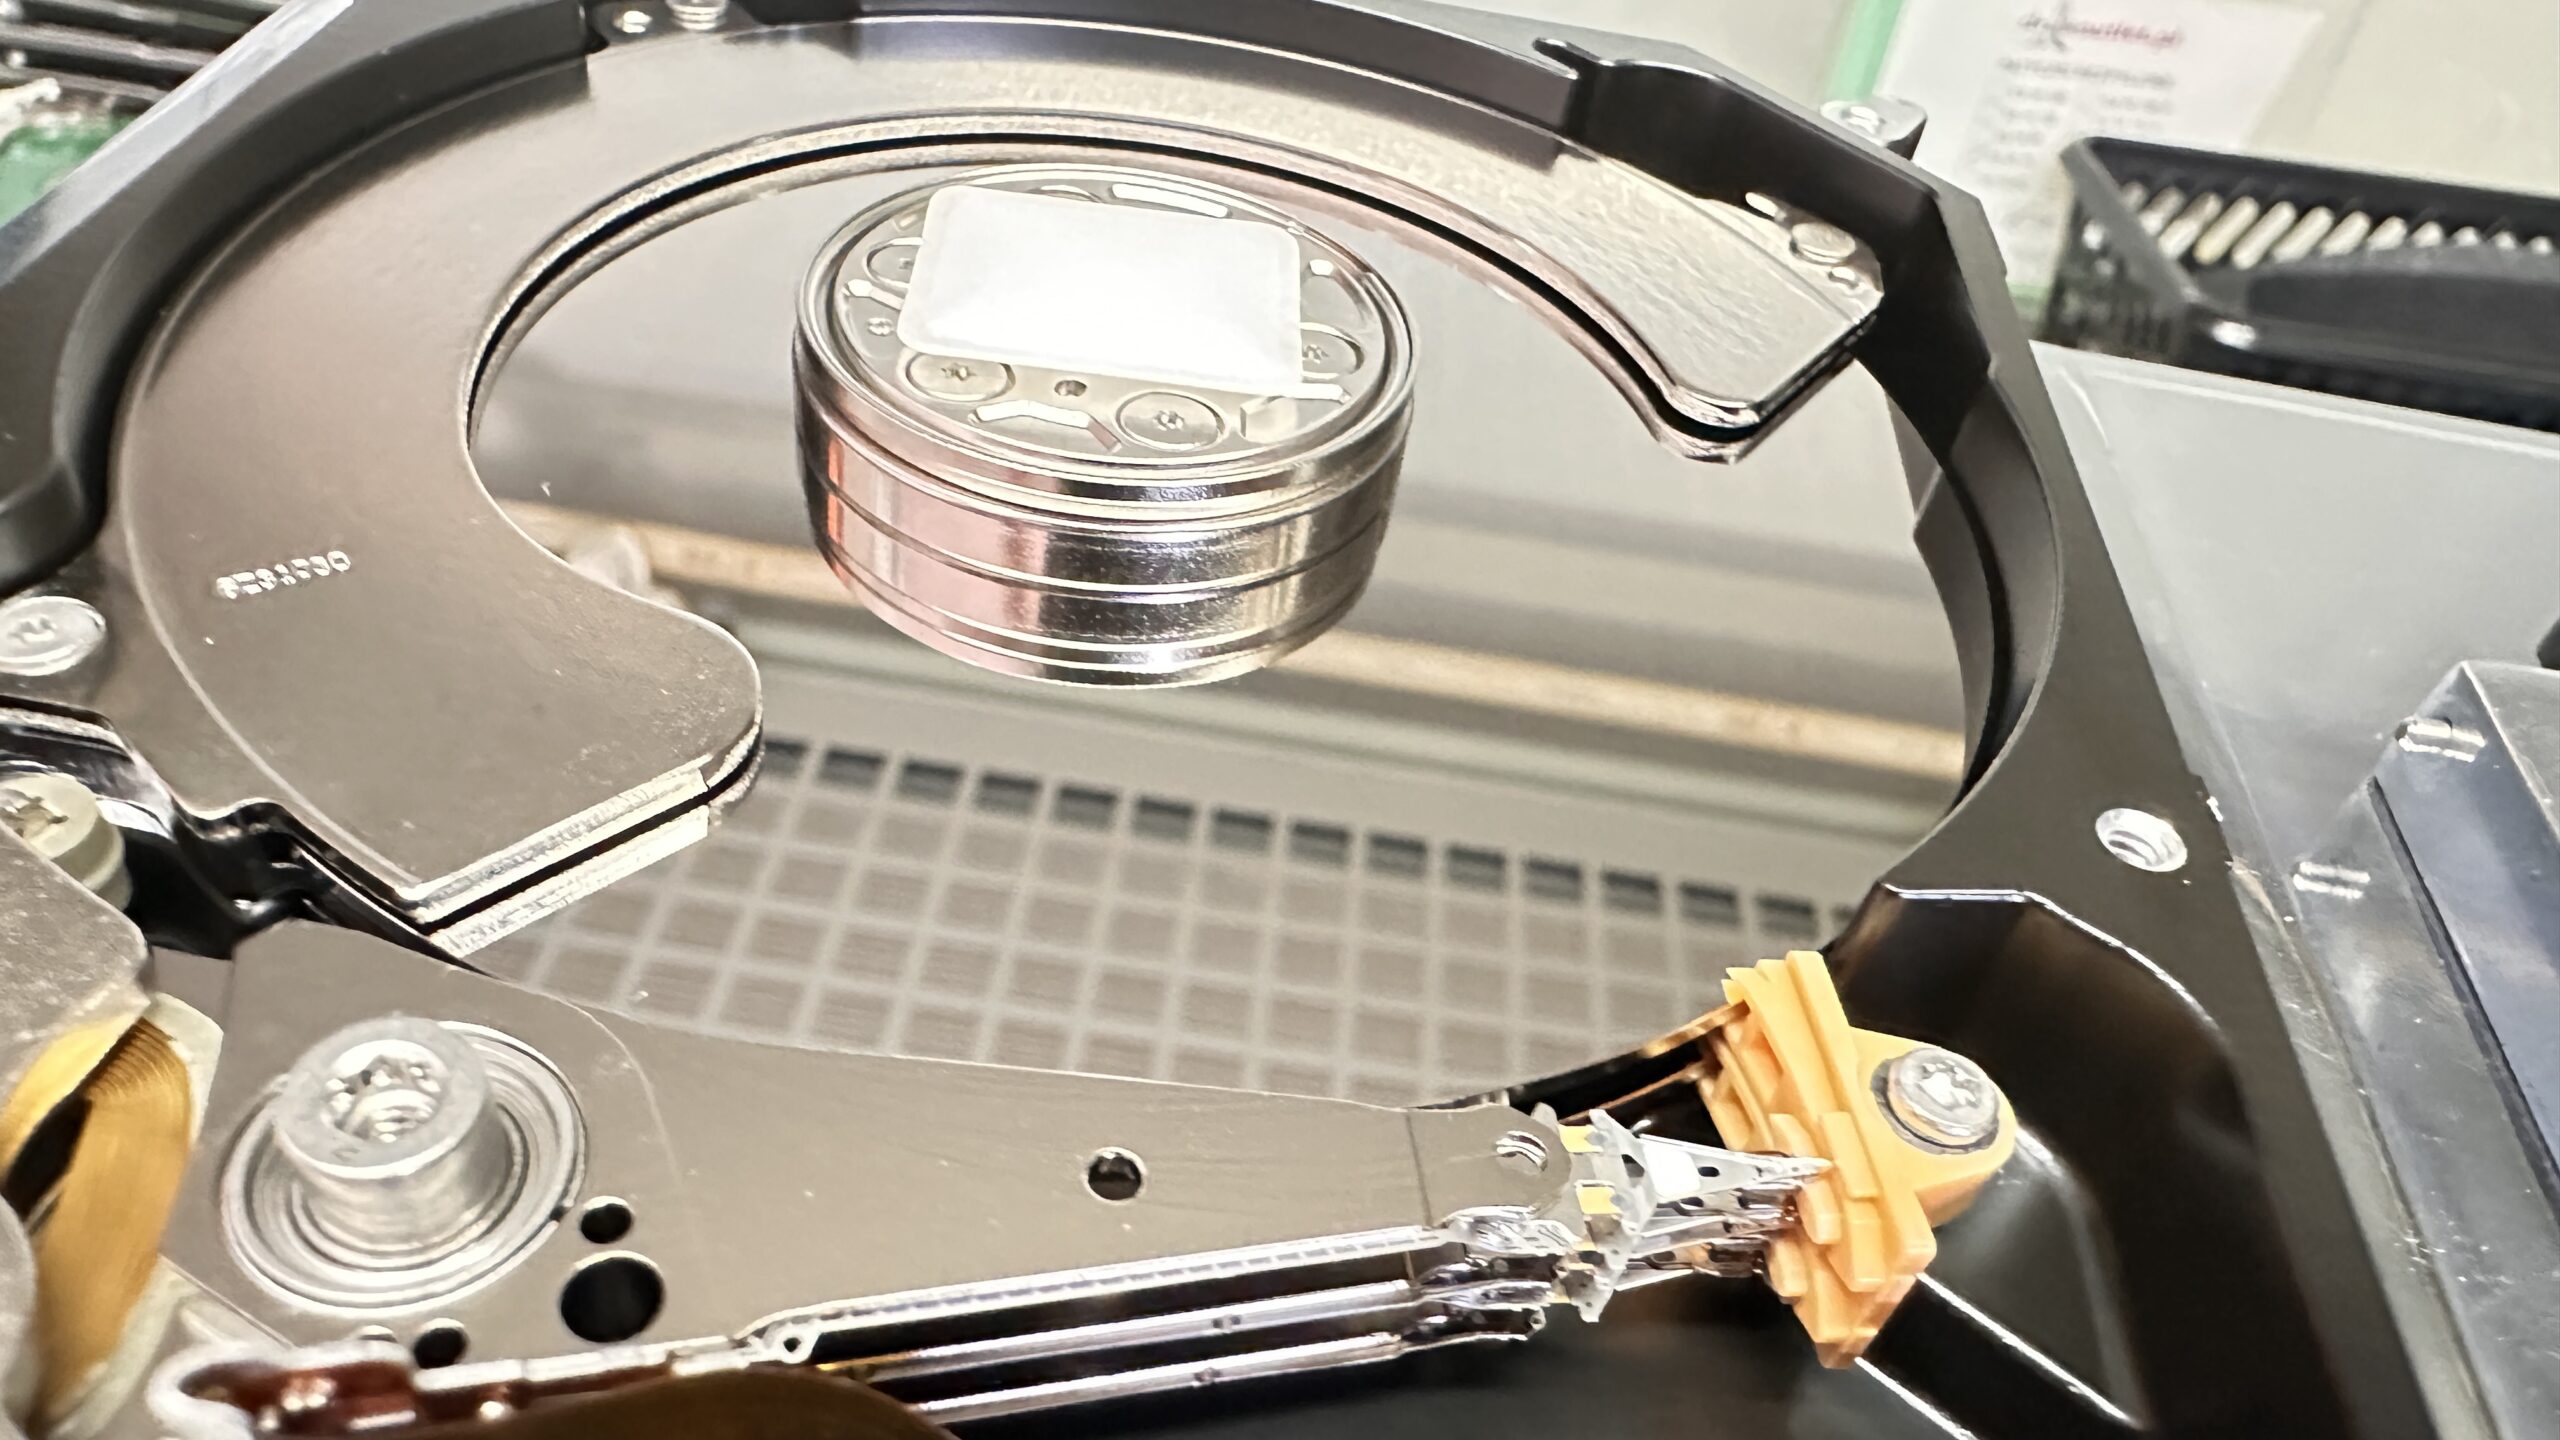
Odzyskanie danych z Seagate ST2000DM001 po serwisach
Do naszego laboratorium trafił Seagate Barracuda ST2000DM001-1E6164 o pojemności 2 TB, który nie zgłaszał się prawidłowo w komputerze. Nośnik miał już za sobą diagnostykę u elektronika oraz w firmie zajmującej się odzyskiwaniem danych. Co więcej, podczas wcześniejszych prób ingerowano zarówno w elektronikę PCB, jak i sam blok dysku.
W takiej sytuacji nie mogliśmy rozpocząć pracy od prostego założenia, że mamy do czynienia wyłącznie z pierwotną awarią. Najpierw trzeba było ustalić rzeczywisty stan urządzenia oraz oddzielić problemy wynikające z jego uszkodzenia od efektów wcześniejszych działań serwisowych.
Ostatecznie z nośnika udało się odzyskać około 99% zawartości zapisanej przed awarią.
Dane techniczne nośnika
Nośnik: dysk twardy Seagate Barracuda 2 TB, 3,5 cala
Model: ST2000DM001-1E6164
Rodzina: Granada
Numer seryjny odczytany z ROM: W1E73WPN
Wersja oprogramowania układowego: GSG2CC
Status zlecenia: proces odzyskiwania danych zakończony sukcesem
Wynik: odzyskano około 99% zawartości zapisanej przed awarią
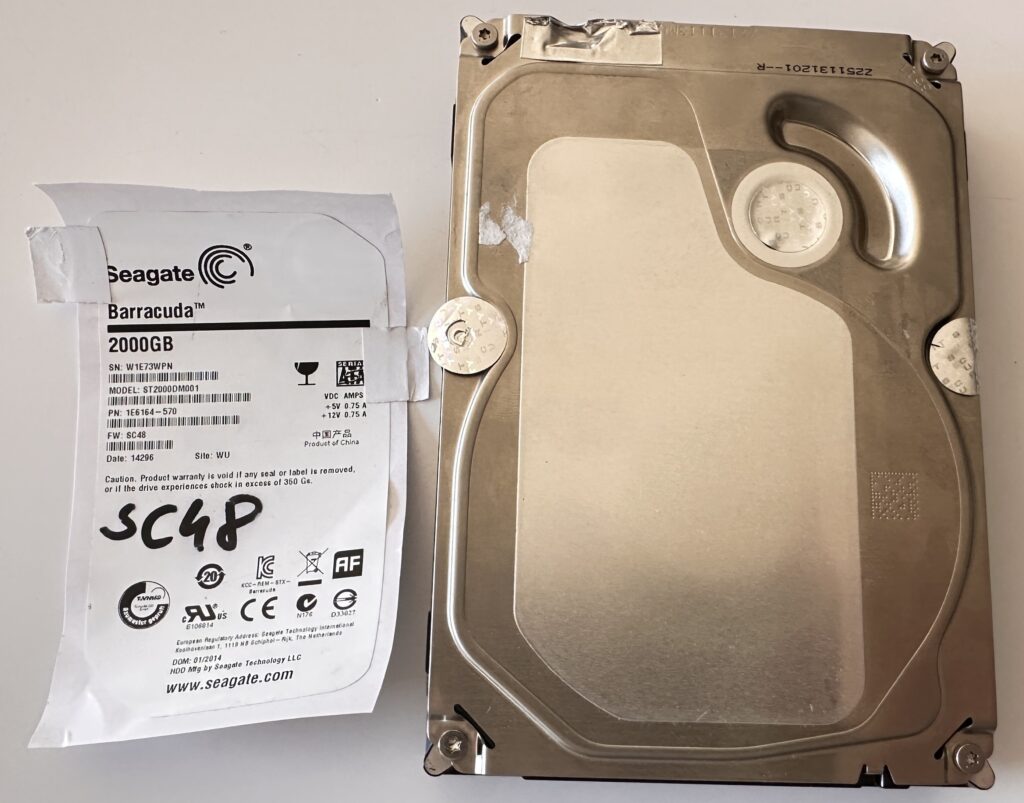
Seagate po dwóch wcześniejszych diagnozach
Historia tego przypadku była nietypowa jeszcze zanim rozpoczęliśmy własną diagnostykę.
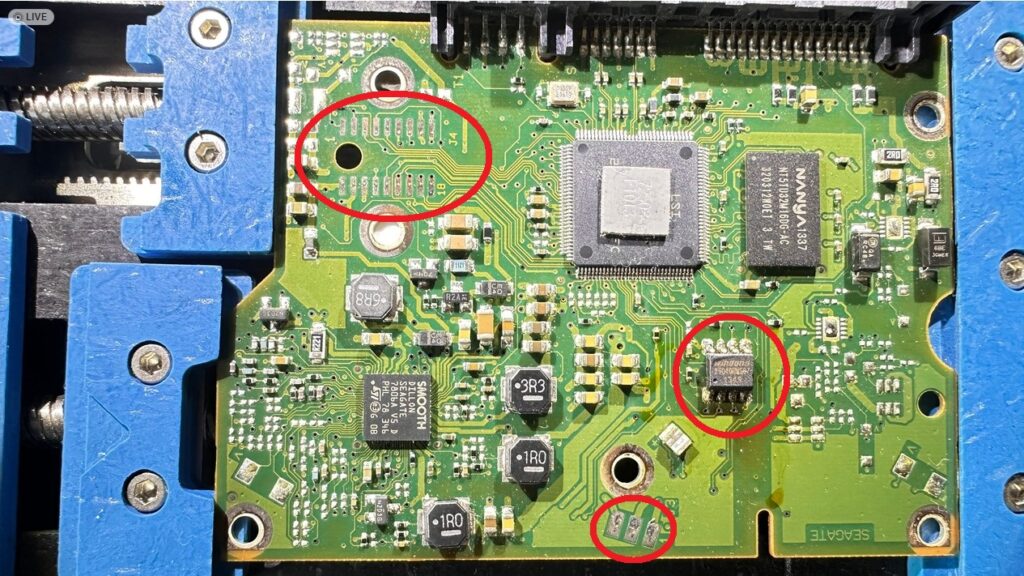
Po wystąpieniu awarii właściciel przekazał urządzenie znajomemu elektronikowi. Ten podejrzewał problem z PCB, dlatego wylutował unikalny układ ROM z fabrycznej elektroniki i przełożył go na inną, nieznaną płytę.
Kiedy taka próba nie przyniosła rezultatu, ROM ponownie trafił na oryginalną PCB.
Dopiero później nośnik został przekazany do firmy zajmującej się odzyskiwaniem danych. Tam obudowę otwarto, a klient otrzymał diagnozę wskazującą na uszkodzenie głowic oraz powierzchnią talerzy.
Zaproponowano mu 3 warianty dalszego postępowania, różniących się deklarowanym prawdopodobieństwem odzysku.
Klient zrezygnował ze względu na koszt i ostatecznie dostarczył urządzenie do naszego laboratorium.
Właśnie dlatego diagnostykę musieliśmy rozpocząć praktycznie od zera.
Trzy problemy, które występowały jednocześnie
W tym przypadku nie mieliśmy jednej prostej usterki. Już podczas pierwszych etapów pracy okazało się, że trzeba analizować równocześnie trzy warstwy: elektronikę, firmware oraz mechanikę.
1. Elektronika PCB i problematyczny ROM
Pierwszą rzeczą, która zwróciła uwagę, był stan płyty PCB.
Elektronika była zabrudzona, natomiast okolice układu ROM nosiły wyraźne ślady wcześniejszych prac lutowniczych. Po uzyskaniu dodatkowych informacji od klienta stało się jasne, dlaczego ten fragment wyglądał inaczej niż fabrycznie.
Układ Winbond w obudowie SOIC-8 został wcześniej co najmniej dwukrotnie poddany operacji lutowania: najpierw podczas przenoszenia na inną PCB, a następnie podczas ponownego montażu na oryginalnej elektronice.
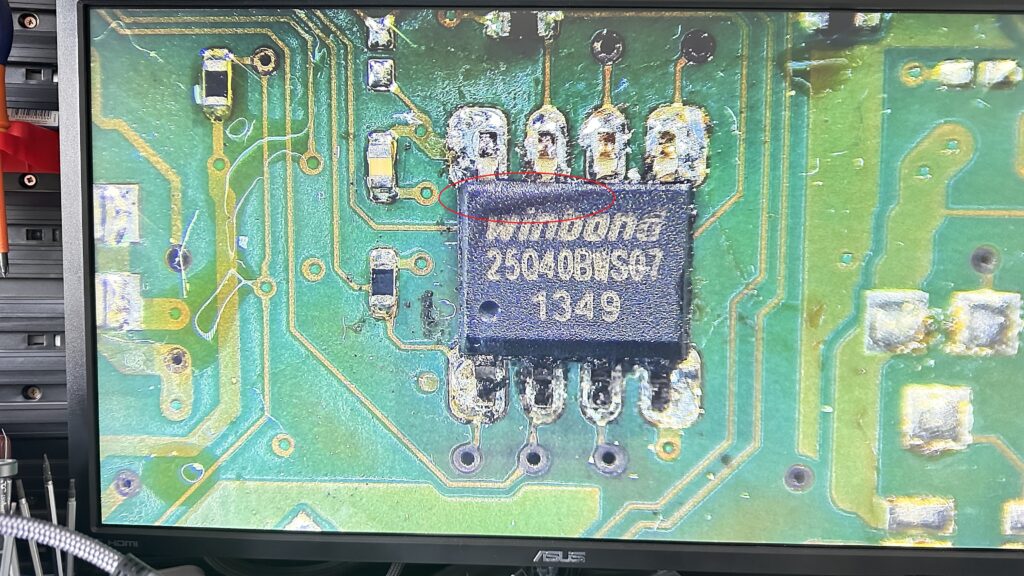
Na obudowie było widać również ślad działania wysokiej temperatury i jej częściową deformację.
To miało bardzo duże znaczenie.
- Mechanizm usterki: Pod wpływem wilgoci, ciągłych zmian temperatur (cykle nagrzewania i chłodzenia nośnika podczas długiej jego pracy) oraz upływu czasu (dysk z 2014 roku!), na stykach pojawia się warstwa tlenków.
- Skutki dla elektroniki: Zwiększona rezystancja na padach zasilania silnika i głowic powoduje mikro-spadki napięć. Przedwzmacniacz (Preamp CB 16) zaczyna dostawać niestabilne zasilanie, co drastycznie pogarsza jakość sygnału zapisu/odczytu (SNR).
- Zabrudzenie głowic: Niestabilny prąd na cewkach pozycjonera mógł powodować nieprawidłowy lot suwaków nad talerzem, co przy gwałtownym wyłączeniu doprowadziło do kontaktu z rampą lub „łapania” mikrocząsteczek z wnętrza obudowy. Dysk zaczął siać błędami odczytu, aż system operacyjny całkowicie stracił z nim kontakt.
ROM zawiera unikalne informacje potrzebne konkretnemu egzemplarzowi nośnika, w tym dane adaptacyjne. Gdyby podczas wcześniejszego lutowania doszło do trwałego uszkodzenia pamięci, dalsze działania mogłyby stać się znacznie trudniejsze.
Dlatego nie zaczęliśmy od prób uruchamiania urządzenia za wszelką cenę. Najpierw należało sprawdzić i zabezpieczyć zawartość ROM-u.
Problemy podczas pracy z ROM-em
Odczyt pamięci nie przebiegał tak, jak w przypadku nienaruszonej elektroniki.
Dopiero znajomość wcześniejszej historii wyjaśniła, dlaczego właśnie ten element sprawiał problemy. Po wielu próbach i naprawach wsadu udało się zabezpieczyć zawartości i można było porównać znajdujące się w niej informacje z oznaczeniami etykiety.
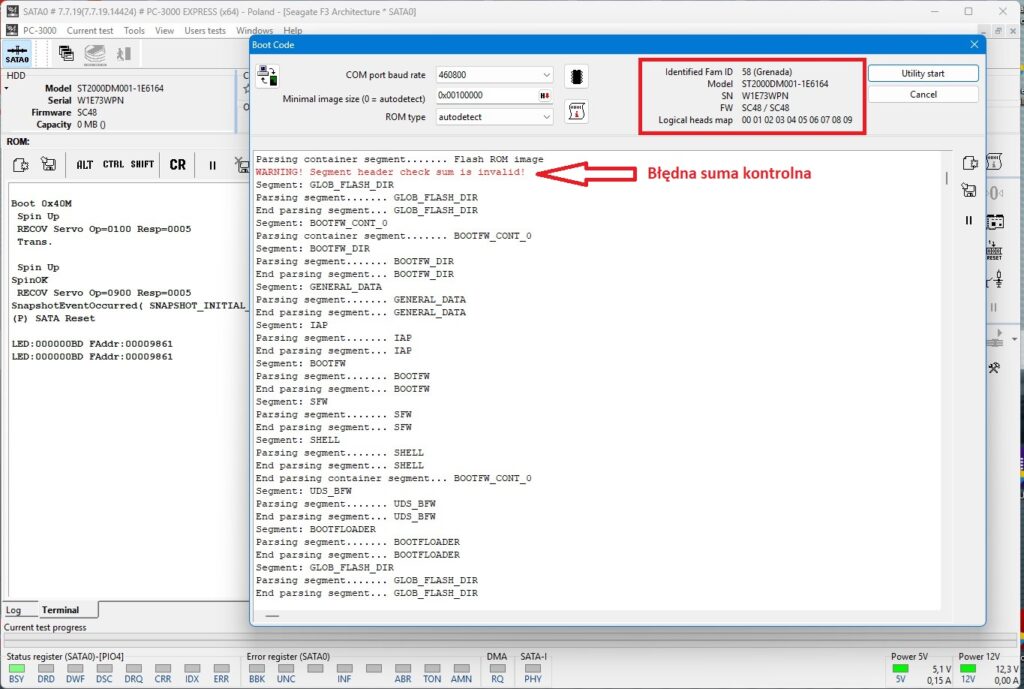
Numer seryjny zapisany w ROM-ie odpowiadał nośnikowi:
W1E73WPN
To potwierdziło, że pracujemy z właściwymi danymi adaptacyjnymi.
2. Firmware i Service Area
Kolejny problem pojawił się już podczas uruchamiania.
Urządzenie nie przechodziło pełnej inicjalizacji i nie zgłaszało prawidłowego ID przez SATA. Terminal zatrzymywał procedurę startową, a jednym z powtarzających się komunikatów był:
LED:000000BD FAddr:00009861Podczas inicjalizacji pojawiała się również sekwencja:
SpinOK
SnapshotEventOccurred( SNAPSHOT_INITIAL_VALUES ).
(P) SATA Reset

Boot 0x40M
Spin
Boot 0x40M
Spin Up
Trans.
LED:000000BD FAddr:00009861
Talerze osiągały właściwe obroty, a firmware rozpoczynał kolejne etapy inicjalizacji. Jednak procedura nie kończyła się normalnym udostępnieniem urządzenia przez interfejs SATA.
Trzeba było odblokować zapętlenie w oprogramowaniu.
Dysk zgłosił gotowość tylko coś jeszcze w nim nie “grało”
To skierowało diagnostykę w stronę Service Area.
Nie można było zakładać, że zastany stan SA jest stanem pierwotnym
W tym miejscu pojawił się dodatkowy problem.
Nośnik był już wcześniej diagnozowany przez dwie różne osoby lub firmy, a my nie dysponowaliśmy kompletnym zapisem wykonanych przez nie operacji. Dlatego nie można było jednoznacznie określić, które nieprawidłowości w Service Area powstały podczas pierwotnej awarii, a które mogły pojawić się później.
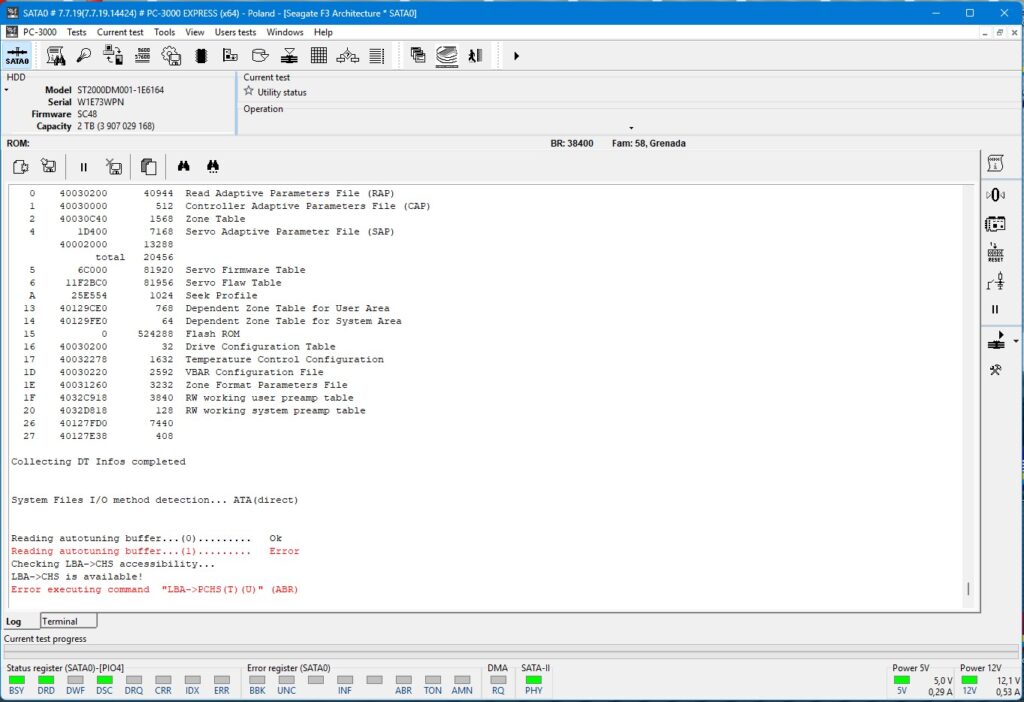
To bardzo istotne w odzyskiwaniu danych.
Przy urządzeniu trafiającym bezpośrednio od właściciela można zazwyczaj analizować awarię w stanie stosunkowo pierwotnym. Tutaj natomiast trzeba było równocześnie brać pod uwagę skutki wcześniejszego lutowania ROM-u, otwarcia HDA oraz ewentualnych działań wykonanych w firmware.
Dlatego zamiast wykonywać kolejne modyfikacje, najpierw zaczęliśmy zabezpieczać to, co jeszcze można było poprawnie odczytać.
Zabezpieczenie translatora
Jednym z kluczowych elementów był translator odpowiadający za powiązanie fizycznej organizacji powierzchni z logiczną adresacją LBA.
Jego stan był problematyczny, dlatego przed dalszymi próbami zabezpieczyliśmy dostępne informacje potrzebne do dalszej pracy.
Tu pojawił się problem odczytu translatora zresztą taki sam jak z odczytem Media Cache o czym napisze poniżej.
Był to jeden z najważniejszych etapów całego zlecenia, ponieważ bez prawidłowej translacji adresów dostęp do właściwego obszaru użytkownika staje się mocno utrudniony albo całkowicie niemożliwy.
Po wykonaniu tej operacji można było przejść dalej.
Media Cache trzeba było pobierać fragmentami
Następnie rozpoczęliśmy zabezpieczanie Media Cache.
Tutaj również nie było łatwo.
Terminal przerywał transmisję, dlatego nie dało się pobrać całej zawartości jednym ciągłym przebiegiem. Kolejne fragmenty trzeba było zapisywać osobno, a następnie kompletować.
Ostatecznie udało się zabezpieczyć Media Cache w całości.
Dopiero mając kopię najważniejszych struktur systemowych, mogliśmy pozwolić sobie na dalszą diagnostykę.
3. Warstwa mechaniczna
Poprzednia firma wskazywała na uszkodzenie głowic oraz powierzchni, dlatego konieczna była również dokładna inspekcja mechaniki.
Blok HDA był już wcześniej otwierany. Fabryczna etykieta zabezpieczająca została naruszona, więc od tego momentu nie można było traktować wnętrza jako nienaruszonego od chwili produkcji.
Podczas pierwszej kontroli filtr nie wyglądał jednak tak, jak można by oczekiwać przy poważnym uszkodzeniu powierzchni.
Głowice również wyglądały na sprawne, no może trochę “zakurzone z upływu czasu”
Po ponownym złożeniu mechaniki wykonaliśmy krótki test pracy.
Talerze rozpędzały się, natomiast urządzenie nadal nie przechodziło pełnej inicjalizacji. W określonych fazach pracy zespół głowic zachowywał się niestabilnie, a brak poprawnej detekcji potwierdzał, że problem jest znacznie bardziej złożony niż sama elektronika.
Test głowic ujawnił rzeczywisty problem
Późniejszy test poszczególnych głowic pokazał skalę problemu.
Dla H0 otrzymaliśmy jeszcze parametry wyglądające wiarygodnie.
Natomiast głowice:
- H1,
- H2,
- H3
zwracały wartości wyraźnie nieprawidłowe.
Nie udało się również zbudować wiarygodnej mapy głowic w Data Extractor. To oznaczało, że nie mogliśmy prowadzić całego procesu w komfortowy sposób, wybierając osobno poszczególne powierzchnie. Ale to wynikało jeszcze z problematycznych odczytów zdegradowanej Strefy Serwisowej.
Mimo tego postanowiliśmy sprawdzić, ile rzeczywiście da się jeszcze uzyskać z obszaru użytkownika.
Pełna struktura logiczna NTFS
I tutaj pojawił się pierwszy bardzo dobry wynik.
PC-3000 Data Extractor uzyskał dostęp do systemu plików NTFS i pozwolił odbudować 100% logicznej struktury zawartości.
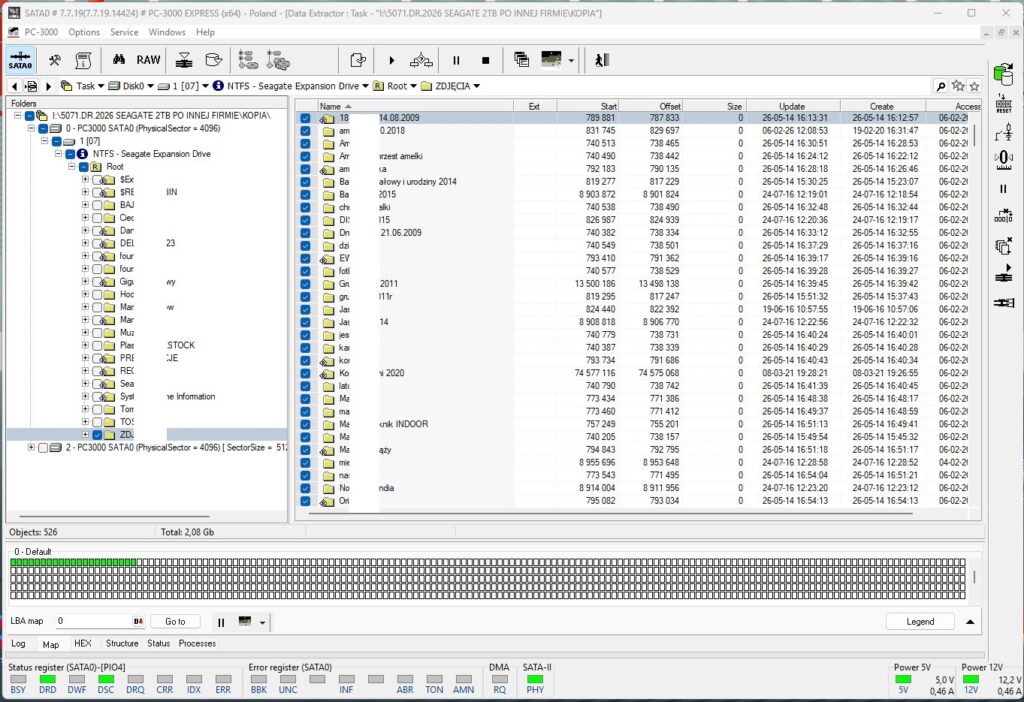
Widoczne były:
- katalogi,
- podkatalogi,
- nazwy plików,
- rozmieszczenie obiektów w systemie plików.
To jednak nadal nie oznaczało stuprocentowego sukcesu.
Pełna struktura logiczna mówi nam, co znajdowało się na nośniku, ale dopiero fizyczne skopiowanie sektorów pokazuje, ile zawartości poszczególnych plików można rzeczywiście uratować.
Dlatego rozpoczął się najdłuższy etap całego zlecenia.
Kopiowanie bez poprawnej mapy głowic
Ponieważ nie udało się wiarygodnie zmapować głowic, kopiowanie trzeba było prowadzić bez pełnej kontroli nad tym, z której powierzchni aktualnie korzystamy.
Priorytetem stało się zebranie tego, co urządzenie nadal zwracało bez większego oporu.
Jeżeli pojawiał się trudniejszy sektor, nie zatrzymywaliśmy całej operacji na kolejnych próbach jego odczytania. Problemowy fragment był pomijany, a proces przechodził dalej.
Najpierw chcieliśmy zabezpieczyć jak największą część łatwo dostępnej zawartości.
Dopiero po wykonaniu głównej kopii można wracać do miejsc wymagających bardziej agresywnych prób.
Zanieczyszczone głowice pogarszały sytuację
W trakcie pracy urządzenie zaczęło się okresowo zawieszać.
Ponowna kontrola mechaniki przyniosła kolejne odkrycie. Na suwakach głowic widoczne były zanieczyszczenia i mikrocząsteczki.
Głowice wymagały oczyszczenia.
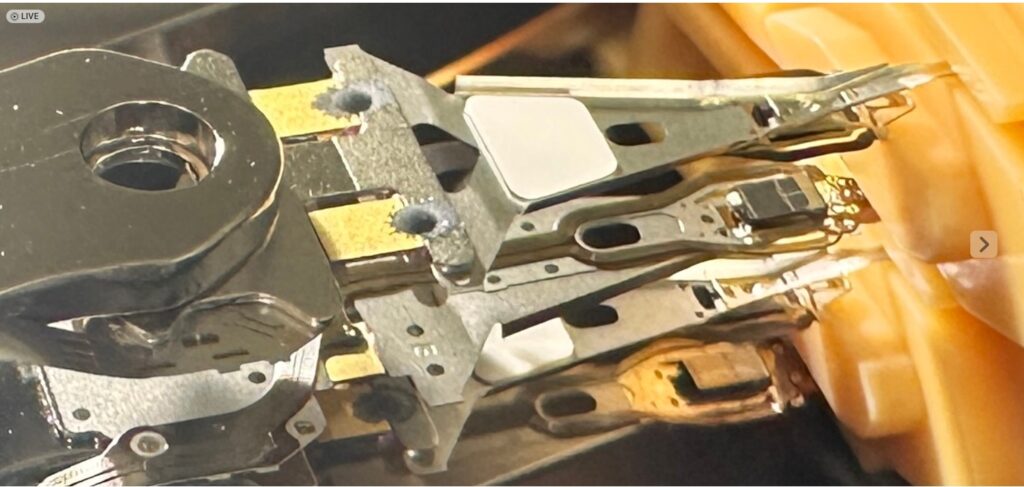
Po wykonaniu tej operacji zachowanie nośnika wyraźnie się poprawiło. Kolejne fragmenty zaczęły przechodzić stabilniej, a liczba przerw podczas kopiowania spadła.
Był to kolejny dowód na to, że w tym przypadku nie walczyliśmy z jedną usterką.
Mieliśmy jednocześnie problematyczną elektronikę, niepewny stan firmware, słabe głowice oraz zabrudzenia wewnątrz HDA.
Nośnik mocno nagrzewał się podczas kopiowania
Kolejnym ograniczeniem okazała się temperatura.
Podczas dłuższej pracy Seagate nagrzewał się na tyle mocno, że nie chcieliśmy utrzymywać go przez wiele godzin pod ciągłym obciążeniem.
Dlatego pracę podzieliliśmy na etapy.
Po określonym czasie zatrzymywaliśmy proces i pozwalaliśmy urządzeniu ostygnąć. Dodatkowo zastosowaliśmy zewnętrzne chłodzenie skierowane bezpośrednio na obudowę.
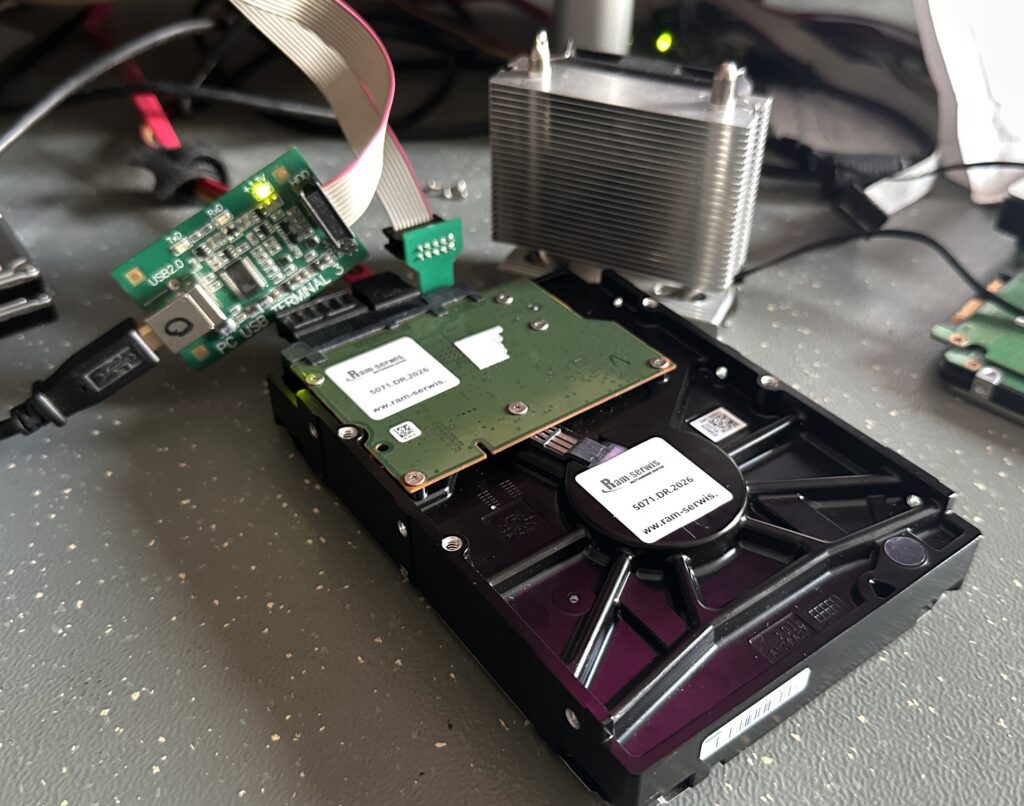
W laboratorium ważniejsze od wyglądu rozwiązania jest to, czy działa. Dlatego obok specjalistycznych narzędzi czasem pojawiają się również całkiem nietypowe „wspomagacze”.
W tym przypadku dodatkowy nawiew spełnił swoje zadanie. Pozwalał dłużej utrzymywać stabilną pracę i ograniczał konieczność częstych przerw.
Najpierw łatwe obszary, później problematyczne sektory
Podczas pierwszego przebiegu świadomie nie wracaliśmy od razu do każdego nieczytelnego miejsca.
To ważna zasada przy mocno osłabionych HDD.
Jeżeli urządzenie ma ograniczony czas stabilnej pracy, znacznie rozsądniej jest najpierw skopiować miliony poprawnie dostępnych sektorów niż zużywać ten czas na wielokrotne próby odzyskania pojedynczego trudnego fragmentu.
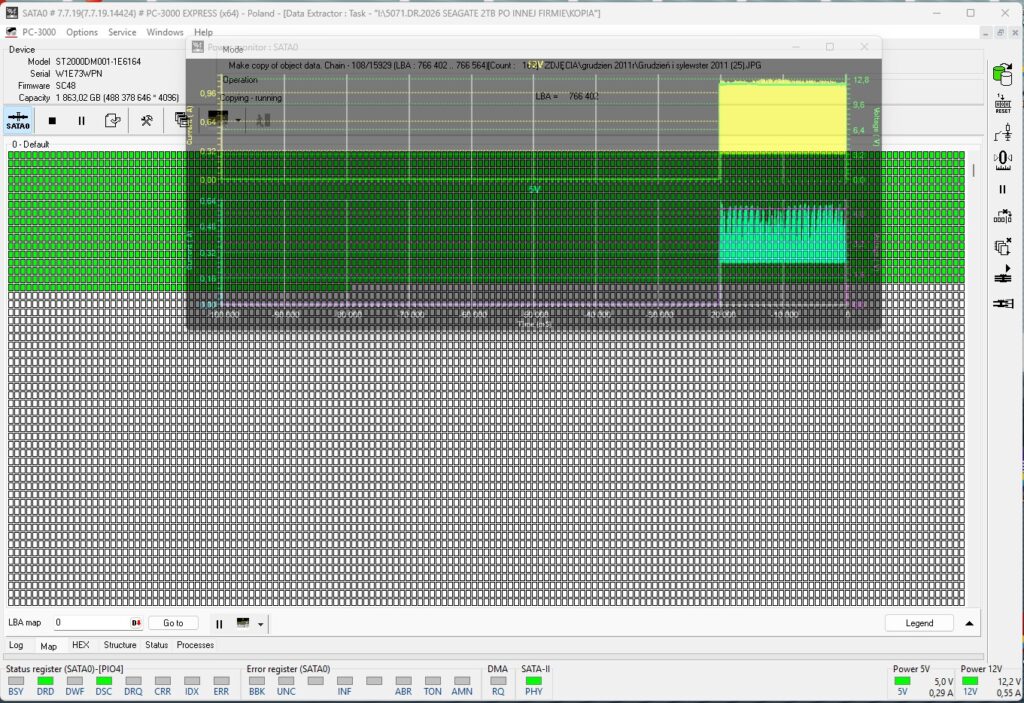
Dzięki temu znaczna część materiału klienta została zabezpieczona już podczas pierwszych etapów.
Ostatni katalog miał ponad 400 GB
Pod koniec pracy pozostał jeden szczególnie duży katalog.
Zawierał ponad 400 GB materiału.
Mimo wcześniejszych problemów kolejne bloki nadal przechodziły poprawnie. Dlatego kontynuowaliśmy proces, kontrolując temperaturę oraz zachowanie mechaniki.
Dopiero po zakończeniu tego katalogu można było rzetelnie podsumować rezultat całego zlecenia.
Odzyskano 99% zawartości Seagate ST2000DM001
Ostateczny wynik wyniósł około 99% zawartości zapisanej na nośniku przed awarią.
Biorąc pod uwagę jego stan oraz wcześniejszą historię, był to bardzo dobry rezultat.
Podczas jednego zlecenia musieliśmy zmierzyć się jednocześnie z:
- Elektroniką PCB po wcześniejszych pracach lutowniczych i przegrzanym układem ROM.
- Problemami z firmware oraz Service Area, których nie można było już jednoznacznie oddzielić od wcześniejszych prób serwisowych.
- Niepełną detekcją urządzenia oraz komunikatem
LED:000000BD FAddr:00009861. - Problemami z H1, H2 i H3 oraz brakiem wiarygodnej mapy głowic.
- Zanieczyszczeniami zespołu głowic, które pogarszały stabilność pracy.
- Pojedynczymi problematycznymi sektorami.
- Silnym nagrzewaniem podczas dłuższego kopiowania.
- Koniecznością pracy etapami i ciągłego dostosowywania strategii do aktualnego zachowania nośnika.
Mimo tych przeszkód udało się odbudować 100% logicznej struktury systemu plików, a następnie fizycznie odzyskać około 99% zapisanej zawartości.
Dlaczego druga diagnoza czasem ma sens
Ten przypadek pokazuje jeszcze jedną ważną rzecz.
Jeżeli urządzenie trafiło wcześniej do kilku serwisów, kolejna diagnostyka może być znacznie trudniejsza niż praca z nośnikiem dostarczonym bezpośrednio po wystąpieniu awarii.
Nie zawsze wiadomo wtedy, które objawy wynikają z pierwotnego problemu, a które pojawiły się później.
Dlatego nie można automatycznie przyjmować wcześniejszej diagnozy za punkt wyjścia.
W tym przypadku zaczęliśmy od własnej kontroli elektroniki, ROM-u, Service Area, mechaniki oraz systemu plików. Dopiero po połączeniu wyników wszystkich tych etapów można było przygotować bezpieczną strategię dalszej pracy.
Równie ważne jest to, że brak detekcji, problemy z głowicami czy wcześniejsze nieudane próby nie zawsze oznaczają, że sytuacja jest beznadziejna.
Czasami inne podejście do zlecenia pozwala uratować zdecydowaną większość materiału.
Tutaj zakończyliśmy pracę wynikiem około 99% odzyskanej zawartości.
Inne przypadki odzyskiwania danych:
Pomagamy również w przypadku:
odzyskiwania danych z dysku SSD
odzysku danych z macierzy RAID
utracie danych w systemach MacOS
Powiązane problemy:
dysk po upadku
dysk nie wykrywa się
SATAFIRM S11
